ปลดล็อก Zypper อย่างปลอดภัยบน SUSE Linux Enterprise
ค้นหาโปรเซสที่กำลังล็อกแพ็กเกจของ Zypper อยู่ แยกแยะความขัดแย้งของโปรเซสออกจากแพ็กเกจที่ถูกล็อก และลองอัปเดตอีกครั้งโดยไม่ต้องลบไฟล์ล็อกโดยไม่รู้สาเหตุ
สำหรับ SLES 15 ให้ลงทะเบียนส่วนขยาย SUSE Linux Enterprise High Availability จากนั้นใช้คำสั่งcrm cluster initเพื่อcrm cluster joinบูตโหนด ก่อนที่จะวางบริการบนคลัสเตอร์ ให้ตรวจสอบเครือข่ายสำรอง การป้องกันโหนด (STONITH) และจำนวนโควรัม
ขั้นตอนการดำเนินการนี้เป็นไปตามเอกสาร SLE HA 15 SP7 ฉบับล่าสุด ณ เดือนตุลาคม 2026 โปรดตรวจสอบ Service Pack ที่ติดตั้งและสถาปัตยกรรม CPU ของคุณ ตัวระบุการลงทะเบียนและรายละเอียดการสนับสนุนอาจแตกต่างกันไป
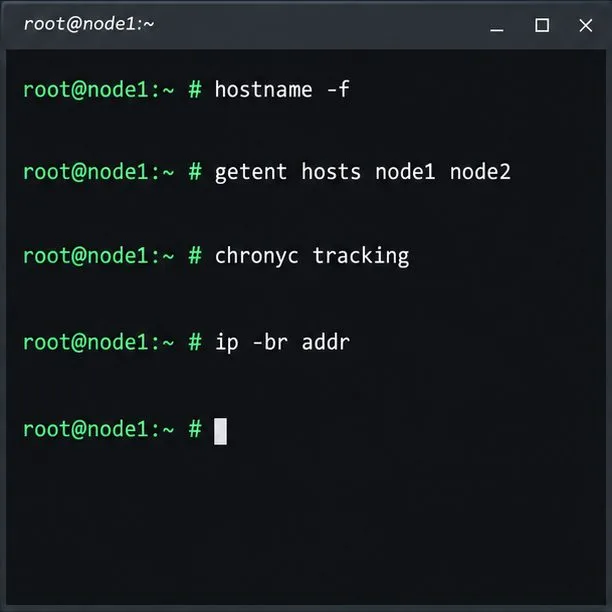
ต้องใช้โหนดอย่างน้อยสองโหนดที่มีสถาปัตยกรรมโปรเซสเซอร์ที่รองรับเหมือนกัน ที่อยู่ IP หลักแบบคงที่ ชื่อที่ไม่ซ้ำกันที่สามารถแก้ไขได้ในทุกโหนด และนาฬิกาที่ซิงโครไนซ์โดยใช้แหล่งเวลาภายนอก SUSE ต้องการเส้นทางการสื่อสาร TCP/IP ที่ซ้ำซ้อนสองเส้นทางต่อโหนด ชื่ออินเทอร์เฟซต้องตรงกันในทุกโหนด
hostname -f
getent hosts node1 node2
chronyc tracking
ip -br addr
ทำการตรวจสอบบนทั้งสองโหนดและยืนยันว่าอินเทอร์เฟซและชื่อที่เลือกถูกต้องก่อนทำการบูตระบบ
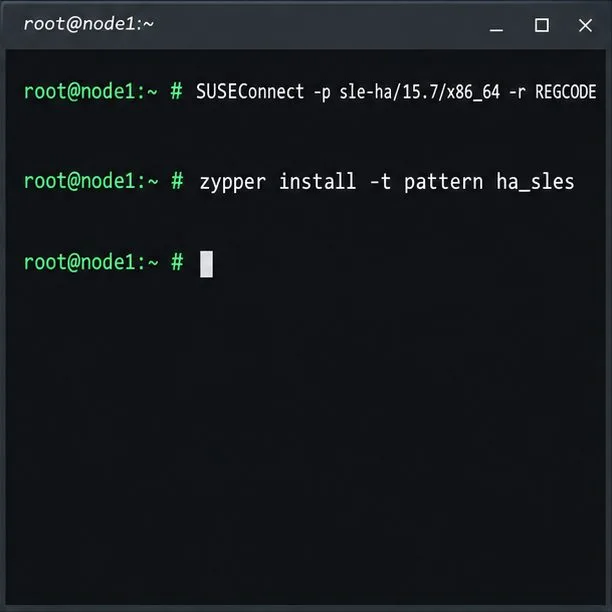
SLE HA เป็นส่วนขยายที่ต้องลงทะเบียนแยกต่างหาก SLES เพียงอย่างเดียวไม่มีรูปแบบคลัสเตอร์ สำหรับโหนด SLES 15 SP7 x86_64 ที่ลงทะเบียนแล้ว ให้เปิดใช้งานส่วนขยายและติดตั้งรูปแบบบนทุกโหนด:
SUSEConnect -p sle-ha/15.7/x86_64 -r ADDITIONAL_REGCODE
zypper install -t pattern ha_slesแทนที่ADDITIONAL_REGCODEด้วยรหัสการสมัครใช้งานของคุณ ตัวระบุผลิตภัณฑ์ใช้สำหรับสถาปัตยกรรม x86_64 เท่านั้น สำหรับสถาปัตยกรรมอื่นๆ ให้ใช้ตัวระบุที่ตรงกันของ SUSE รักษาโหนดทั้งหมดให้อยู่ในระดับ SLES SP และ SLE HA เดียวกัน ดูคู่มือการติดตั้ง SLE HA 15 SP7 ของ SUSE
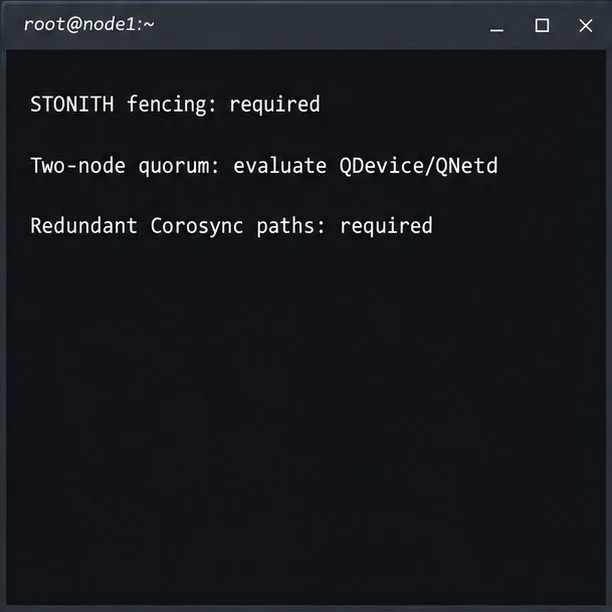
จำเป็นสำหรับคลัสเตอร์ที่รองรับ:การแยกโหนด (STONITH) โดยตั้งค่าเป็น true stonith-enabledและstartup-fencingปล่อยว่างไว้ การแยกโหนดจะแยกโหนดที่ไม่แน่นอนเพื่อป้องกันไม่ให้ทั้งสองด้านของพาร์ติชันเรียกใช้บริการเดียวกัน เลือกอุปกรณ์ควบคุมพลังงานหรือ SBD ที่รองรับพร้อม watchdog ที่ผ่านการทดสอบแล้วสำหรับฮาร์ดแวร์หรือไฮเปอร์ไวเซอร์ของคุณ
สำหรับคลัสเตอร์ที่มีสองโหนด: SUSE แนะนำให้ใช้ QDevice/QNetd สำหรับคลัสเตอร์ที่มีจำนวนโหนดเป็นเลขคู่ ระบบนี้จะเพิ่มการลงคะแนนเสียงควอรัมแบบอิสระ ไม่ใช่การป้องกัน หากต้องการรวม QDevice ในระหว่างการบูตระบบ ให้กำหนดค่าเซิร์ฟเวอร์ QNetd แยกต่างหากก่อน ดูรายละเอียดเพิ่มเติมได้ในคู่มือ QDevice และ QNetd
ความเข้าใจผิดเกี่ยวกับการจัดเก็บข้อมูล:การจัดเก็บข้อมูลแบบใช้ร่วมกันไม่ใช่สิ่งจำเป็นสำหรับทุกคลัสเตอร์ แต่ข้อมูลแอปพลิเคชันจำเป็นต้องมีการออกแบบการจัดเก็บข้อมูลแบบใช้ร่วมกัน การจำลอง หรือการกู้คืนเป็นของตัวเอง Pacemaker ทำหน้าที่ย้ายทรัพยากร ไม่ได้คัดลอกข้อมูลแอปพลิเคชัน
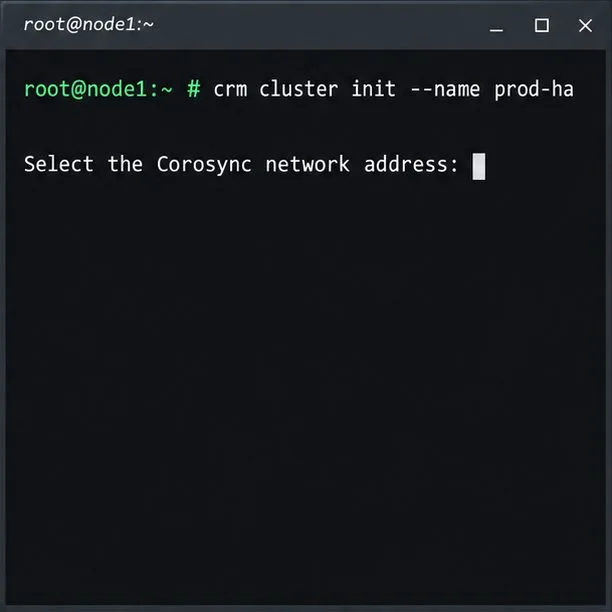
บนโหนด 1 ให้เริ่มการบูต CRM Shell ในฐานะผู้ใช้ root หรือผ่านการตั้งค่าผู้ใช้ sudo ที่ได้รับการอนุมัติของคุณ:
crm cluster init --name prod-haทำตามคำแนะนำและเลือกที่อยู่ Corosync ที่ต้องการ สคริปต์จะกำหนดค่า Corosync, SSH, Csync2, พอร์ตไฟร์วอลล์คลัสเตอร์ และ Hawk2 ตรวจสอบการซิงค์เวลา และเสนอตัวเลือก SBD และ IP สำหรับการดูแลระบบ Hawk2 ตรวจสอบ/var/log/crmsh/crmsh.logการตั้งค่าบูตสแตรป
ตั้งค่า watchdog บนแต่ละโหนดก่อนเลือก SBD หากใช้ fencing ภายนอก ให้กำหนดค่าทรัพยากร STONITH ที่รองรับก่อนเรียกใช้งานเวิร์กโหลด ห้ามปิดใช้งาน STONITH เพื่อหลีกเลี่ยงอุปกรณ์ที่หายไป Bootstrap สร้างคลัสเตอร์พื้นฐาน ไม่ใช่แอปพลิเคชัน HA
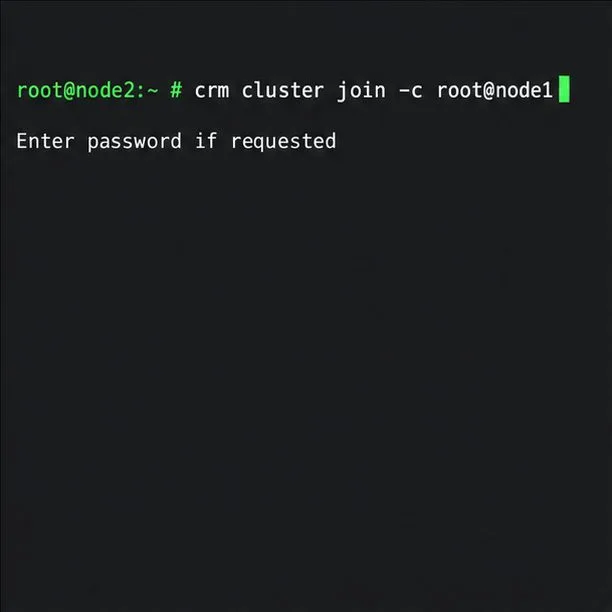
ติดตั้งและลงทะเบียน SLE HA บนโหนด 2 หากใช้ SBD ให้เตรียม watchdog ไว้ที่นั่นก่อนเข้าร่วม จากนั้น ในฐานะ root:
crm cluster join -c root@node1สำหรับการตั้งค่าด้วยผู้ใช้ sudo ให้ทำUSER@NODE1ตามขั้นตอนของ SUSE ระบุอินเทอร์เฟซสองตัวเดียวกันหากกำหนดค่าไว้ในระหว่างการเริ่มต้น สคริปต์จะคัดลอกการตั้งค่า Corosync ตั้งค่า SSH และ Csync2 และทำให้ node2 ออนไลน์ ทำซ้ำสำหรับโหนดเพิ่มเติม อย่าผสมผสานวิธีการตั้งค่า bootstrap และ YaST เข้าด้วยกัน

จากโหนดคลัสเตอร์ ตรวจสอบสถานะการเป็นสมาชิก:
crm statusตรวจสอบให้แน่ใจว่าทั้งสองโหนดออนไลน์และมีจำนวนโหนดที่เพียงพอ (quorum) การบูตสแตรปจะสร้างhaclusterด้วยรหัสผ่านเริ่มต้นlinuxโปรดเปลี่ยนรหัสผ่านในแต่ละโหนดที่เริ่มต้นใช้งาน:
passwd haclusterHawk2 ใช้ HTTPS บนพอร์ต7630โปรดตรวจสอบใบรับรองแบบลงนามด้วยตนเองกับผู้ดูแลระบบของคุณก่อนที่จะเชื่อถือ ที่อยู่ IP สำหรับการจัดการของ Hawk2 ไม่ใช่ที่อยู่ไคลเอ็นต์ของแอปพลิเคชัน
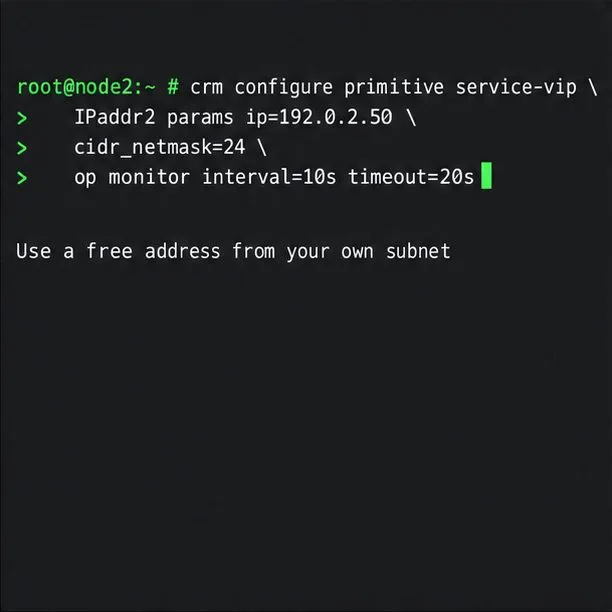
Pacemaker จัดการบริการผ่านตัวแทนทรัพยากร ติดตั้งและกำหนดค่าเวิร์กโหลดให้เหมาะสมบนโหนดที่มีสิทธิ์ ตัวอย่างนี้สร้างเฉพาะส่วนประกอบ IP แบบลอยตัวเท่านั้น:
crm configure primitive service-vip IPaddr2 params ip=192.0.2.50 cidr_netmask=24 op monitor interval=10s timeout=20s192.0.2.50สงวนไว้สำหรับเอกสารประกอบ แทนที่ด้วยที่อยู่ว่างและคำนำหน้าที่ถูกต้องจากซับเน็ตของคุณ IP primitive ไม่ได้เริ่มต้นแอปพลิเคชันหรือจำลองข้อมูล เพิ่มเอเจนต์ที่รองรับของแอปพลิเคชัน รวมถึงลำดับเฉพาะของเวิร์กโหลด การจัดวางร่วม และพฤติกรรมการจัดเก็บข้อมูล ปฏิบัติตามคำแนะนำการกู้คืนและการป้องกันของผลิตภัณฑ์นั้น
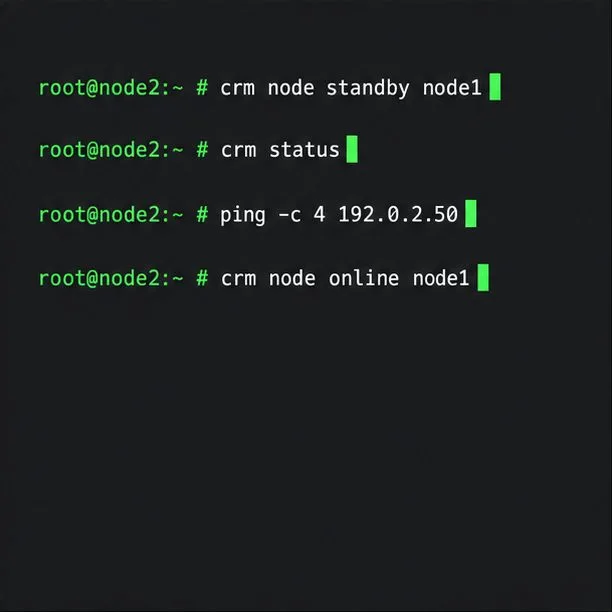
หลังจากกำหนดค่าทรัพยากรจริงและระบบป้องกันแล้ว ให้กำหนดเวลาทดสอบการสลับการทำงานเมื่อเกิดข้อผิดพลาด โดยตั้งค่าโหนด 1 เป็นโหมดสแตนด์บายและตรวจสอบบริการจากโหนด 2:
crm node standby node1
crm status
ping -c 4 SERVICE_VIP
crm node online node1แทนที่SERVICE_VIPด้วยที่อยู่ไคลเอ็นต์จริง ตรวจสอบว่าแอปพลิเคชันตอบสนอง ทรัพยากรเคลื่อนย้ายตามที่คาดไว้ และโหนด 1 เข้าร่วมเครือข่ายอีกครั้ง การตรวจสอบ Ping ตรวจสอบเฉพาะการเข้าถึงเครือข่ายเท่านั้น SUSE crm cluster crash_testจงใจทำให้ส่วนประกอบต่างๆ หยุดทำงาน ดังนั้นควรใช้ในสภาพแวดล้อมการทดสอบที่วางแผนไว้ อ่าน คู่มือเริ่ม ต้น ใช้งานอย่างรวดเร็ว และคู่มือการสร้างรั้วสำหรับการติดตั้ง SLE HA
หลังจากทำการทดสอบแล้ว ให้ยืนยันว่าโหนดทั้งสองมีสถานะตามที่คาดหวังไว้ การป้องกันยังคงเปิดใช้งานอยู่ และเวิร์กโหลดตอบกลับผ่านทางเอนด์พอยต์ไคลเอ็นต์หลังจากที่โหนด 1 กลับมาออนไลน์แล้ว การแสดงสถานะสมาชิกสีเขียวหรือการ ping ที่สำเร็จเพียงอย่างเดียวไม่ได้พิสูจน์ว่าแอปพลิเคชันกลับมาใช้งานได้แล้ว
ค้นหาโปรเซสที่กำลังล็อกแพ็กเกจของ Zypper อยู่ แยกแยะความขัดแย้งของโปรเซสออกจากแพ็กเกจที่ถูกล็อก และลองอัปเดตอีกครั้งโดยไม่ต้องลบไฟล์ล็อกโดยไม่รู้สาเหตุ
ลงทะเบียน SLE HA, บูตสแตรปโหนด SLES 15 จากนั้นเพิ่มการป้องกัน, โควรัม และทรัพยากรบริการที่ผ่านการทดสอบก่อนที่จะพึ่งพาการสลับระบบเมื่อเกิดข้อผิดพลาด
ตรวจสอบหาสาเหตุของข้อผิดพลาดในการรีเฟรชของ Zypper ว่ามาจาก SUSE, RMT หรืออุปกรณ์ปลายทางของบุคคลที่สาม จากนั้นใช้การแก้ไขปัญหาฝั่งเซิร์ฟเวอร์หรือแคชที่ถูกต้องโดยไม่ต้องปิดใช้งานการอัปเดตที่จำเป็น
แก้ไขข้อผิดพลาดเกี่ยวกับพื้นที่ thin-pool ของ SUSE LVM โดยการตรวจสอบการใช้งานข้อมูลและเมตาเดต้า ขยายพูลอย่างปลอดภัย และป้องกันการหยุดทำงานซ้ำซ้อน
ตรวจสอบว่า Btrfs ถูกตั้งค่าเป็นโหมดอ่านอย่างเดียวโดยเจตนา พื้นที่เหลือน้อย หรือกำลังปกป้องข้อมูลหลังเกิดข้อผิดพลาด จากนั้นเลือกวิธีการกู้คืนที่เหมาะสมกับสาเหตุ
เตรียมช่องสัญญาณจำลอง สร้างคีย์การเปิดใช้งาน และบูตสแตรปไคลเอ็นต์ SLES 15 โดยไม่ต้องเข้าถึงอินเทอร์เน็ตโดยตรง ในขณะที่ยังคงรักษาการเชื่อมต่อที่จำเป็นสำหรับการเช็คอินของผู้จัดการไว้
แก้ไขข้อผิดพลาดในการเปิดใช้งาน XIO ของ YaST ผ่าน SSH ตรวจสอบการส่งต่อ X11 และ xauth และสลับไปใช้ส่วนติดต่อ ncurses เมื่อไม่จำเป็นต้องใช้หน้าต่างระยะไกล
ค้นหาสแนปช็อต Btrfs ก่อนการอัปเดต ทดสอบในโหมดอ่านอย่างเดียว และทำให้การกู้คืนเป็นแบบถาวรด้วย Snapper พร้อมทั้งทำความเข้าใจว่าข้อมูลใดบ้างที่อยู่นอกเหนือการย้อนกลับแบบรูท
ส่งบันทึกระบบ SLES ไปยังตัวเก็บรวบรวม rsyslog ระยะไกลผ่าน TLS ที่มีการตรวจสอบสิทธิ์ พร้อมด้วยการตรวจสอบใบรับรอง การบัฟเฟอร์เมื่อระบบขัดข้อง และการทดสอบการส่งมอบ
ใช้บันทึก RAM, swap, kernel และ Zypper เพื่อระบุแรงดันหน่วยความจำที่แท้จริง ป้องกันสถานะของแพ็กเกจ และเลือกวิธีการลองอัปเกรด SLES ที่ปลอดภัยยิ่งขึ้น







