Collabora Online เทียบกับ ONLYOFFICE: วัดค่า RAM และความหน่วงในการตัดต่อ
เปรียบเทียบ Collabora Online และ ONLYOFFICE Docs บนเซิร์ฟเวอร์เดียวกัน โดยใช้การทดสอบที่ทำซ้ำได้เพื่อวัดการใช้หน่วยความจำ เวลาในการเปิดเอกสาร และความล่าช้าในการแก้ไขร่วมกัน
การหยุดทำงานของแพลตฟอร์มคลาวด์ในวงกว้างนั้น แทบจะไม่เคยเกิดจากการที่เซิร์ฟเวอร์เพียงเครื่องเดียว "ล่ม" เลย เหตุการณ์ที่ก่อให้เกิดความเสียหายมากที่สุดมักจะเริ่มต้นจากความผิดพลาดทางเทคนิคเพียงอย่างเดียว เช่น การกำหนดค่าที่ไม่ถูกต้อง ข้อบกพร่องของซอฟต์แวร์ ปัญหา DNS ความล้มเหลวของเครือข่าย หรือเหตุการณ์ด้านโครงสร้างพื้นฐาน แล้วจึงแพร่กระจายออกไป เนื่องจากบริการจำนวนมากขึ้นอยู่กับระบบควบคุม ฐานข้อมูล ระบบยืนยันตัวตน ตัวกระจายโหลด หรือทรัพยากรระดับภูมิภาคเดียวกัน
สถานการณ์จำลอง:ลองจินตนาการถึงผู้ให้บริการคลาวด์สมมติชื่อ Northstar Cloud เวลา 10:05 น. การเปลี่ยนแปลงเครือข่ายอัตโนมัติถูกนำไปใช้กับบริการระดับภูมิภาค ภายในไม่กี่นาที ลูกค้าเริ่มรายงานว่าการเรียกใช้ API ล้มเหลว เวลา 10:12 น. เครื่องเสมือนใหม่หยุดทำงาน เวลา 10:20 น. ตัวจัดการโหลดเริ่มทำเครื่องหมายแบ็กเอนด์ที่ทำงานได้ปกติว่าไม่พร้อมใช้งาน เวลา 10:35 น. ผลิตภัณฑ์หลายสิบรายการที่ดูเหมือนไม่เกี่ยวข้องกันเริ่มทำงานผิดปกติ สถานการณ์นี้เป็นเพียงสมมติฐาน ไม่ใช่คำอธิบายของการหยุดชะงักที่เกิดขึ้นจริง แต่มีประโยชน์เพราะแสดงให้เห็นว่าเหตุใดความผิดพลาดเล็กๆ น้อยๆ ในตอนเริ่มต้นจึงสามารถกลายเป็นเหตุการณ์ใหญ่ระดับแพลตฟอร์มได้
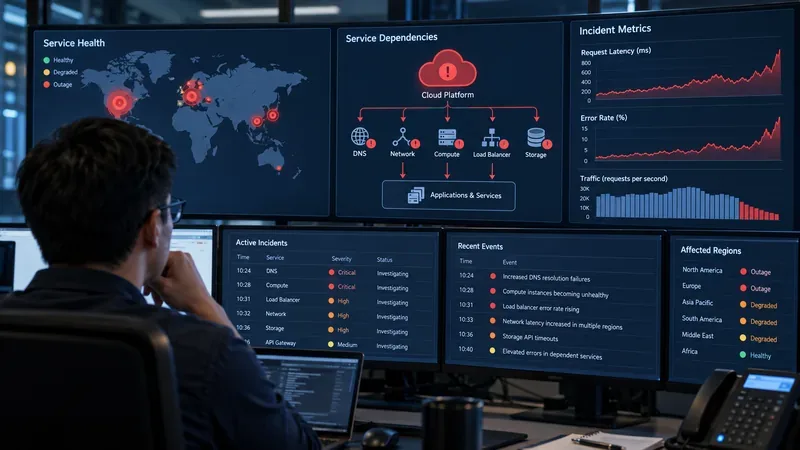
สาเหตุหลักที่ทำให้แพลตฟอร์มคลาวด์หยุดทำงานในวงกว้าง ได้แก่ ข้อผิดพลาดในการกำหนดค่าและการติดตั้งใช้งาน ข้อบกพร่องของซอฟต์แวร์ที่แฝงอยู่ ความล้มเหลวของ DNS และการกำหนดเส้นทาง การพึ่งพาบริการร่วมกัน การหมดกำลังการรองรับระหว่างการล้มเหลวหรือการกู้คืน ปัญหาในส่วนควบคุม และความล้มเหลวทางกายภาพที่ส่งผลกระทบต่อศูนย์ข้อมูลหรือโซนความพร้อมใช้งาน ขนาดของการหยุดทำงานนั้นขึ้นอยู่กับว่าส่วนประกอบที่ได้รับผลกระทบนั้นถูกใช้งานร่วมกันในวงกว้างมากกว่าข้อผิดพลาดแรก
ตัวอย่างที่ใช้ได้จริงและมีประโยชน์มาจาก AWS ในรายงานสรุปหลังเหตุการณ์อย่างเป็นทางการเกี่ยวกับการหยุดชะงักในเวอร์จิเนียตอนเหนือเมื่อเดือนตุลาคม 2025 AWS ระบุว่าเงื่อนไขการแข่งขันแฝงในระบบจัดการ DNS อัตโนมัติของ DynamoDB ทำให้เกิดระเบียน DNS ว่างเปล่าที่ไม่ถูกต้องสำหรับปลายทางระดับภูมิภาค ความล้มเหลวของ DNS ดังกล่าวส่งผลกระทบต่อลูกค้าและบริการภายในของ AWS ที่พึ่งพา DynamoDB และงานกู้คืนในภายหลังทำให้เกิดปัญหาเกี่ยวกับการเปิดใช้งาน EC2 และ Network Load Balancers เหตุการณ์นี้ได้รับการบันทึกไว้ในรายงานสรุปหลังเหตุการณ์ของ AWS เกี่ยวกับการหยุดชะงักของ DynamoDB ในเดือนตุลาคม 2025
ข้อผิดพลาดในการกำหนดค่าเป็นหนึ่งในรูปแบบที่พบบ่อยที่สุดในเหตุการณ์ที่เกิดขึ้นกับระบบกระจายขนาดใหญ่ เนื่องจากแพลตฟอร์มสมัยใหม่ถูกควบคุมด้วยระบบอัตโนมัติ การเปลี่ยนแปลงเพียงครั้งเดียวสามารถส่งไปยังโฮสต์ เราเตอร์ บันทึก DNS หรือจุดเชื่อมต่อบริการนับพันได้เร็วกว่าที่ผู้ปฏิบัติงานที่เป็นมนุษย์จะแก้ไขด้วยตนเองได้
กลับมาที่สถานการณ์ของ Northstar Cloud สมมติว่าการเปลี่ยนแปลงเครือข่ายเวลา 10:05 น. มีจุดประสงค์สำหรับเครื่องสิบเครื่อง แต่กลับถูกนำไปใช้กับหลายภูมิภาค การเปลี่ยนแปลงไม่จำเป็นต้องทำลายฮาร์ดแวร์ อาจเพียงแค่ลดความจุเครือข่ายที่ใช้งานได้ เปลี่ยนแปลงการกำหนดเส้นทาง หรือทำให้ระบบปฏิเสธการรับส่งข้อมูลที่ปกติแล้วใช้งานได้ดี เมื่อความจุที่ใช้ร่วมกันลดลงต่ำกว่าความต้องการ ลูกค้าจะพบกับการหมดเวลาและการลองใหม่ ซึ่งจะสร้างภาระเพิ่มขึ้นไปอีก
Google อธิบายกลไกที่คล้ายกันในรายงานอย่างเป็นทางการเกี่ยวกับการหยุดชะงักของบริการในปี 2019 ว่า การเปลี่ยนแปลงการกำหนดค่าที่ตั้งใจไว้สำหรับเซิร์ฟเวอร์จำนวนเล็กน้อยในภูมิภาคหนึ่ง ถูกนำไปใช้ในวงกว้างอย่างไม่ถูกต้อง ทำให้หลายภูมิภาคไม่สามารถใช้งานความจุเครือข่ายได้มากกว่าครึ่งหนึ่ง ส่งผลให้ปริมาณการใช้งานไปติดขัดในความจุที่เหลืออยู่ ดูข้อมูลอัปเดตอย่างเป็นทางการของ Google เกี่ยวกับการหยุดชะงักของบริการในปี 2019 ได้ที่ นี่
นี่คือเหตุผลที่ผู้ให้บริการคลาวด์ที่มีประสบการณ์จะใช้การทยอยเปิดใช้งาน การตรวจสอบความถูกต้อง การย้อนกลับอัตโนมัติ การจำกัดอัตราการเปลี่ยนแปลง และการควบคุม "ขอบเขตความเสียหาย" มาตรการป้องกันเหล่านี้ไม่ได้ขจัดเหตุการณ์ไม่พึงประสงค์ทั้งหมด แต่สามารถป้องกันไม่ให้การเปลี่ยนแปลงที่ผิดพลาดเพียงครั้งเดียวกลายเป็นเหตุการณ์ที่ส่งผลกระทบต่อทั้งแพลตฟอร์มได้
แพลตฟอร์มคลาวด์ขนาดใหญ่ใช้งานซอฟต์แวร์แบบกระจายจำนวนมหาศาล ข้อบกพร่องบางอย่างอาจซ่อนเร้นอยู่เป็นเวลาหลายเดือนหรือหลายปี เนื่องจากต้องอาศัยลำดับเหตุการณ์ที่เกิดขึ้นได้ยาก เช่น ตัวควบคุมสองตัวอัปเดตสถานะเดียวกัน ความล่าช้าที่ผิดปกติ เมตาเดต้าที่ล้าสมัย หรือกระบวนการกู้คืนที่ทำงานพร้อมกับกระบวนการทำความสะอาดในเวลาเดียวกัน
ในเหตุการณ์สมมติเรื่องนอร์ธสตาร์ ลองจินตนาการว่าระบบอัตโนมัติสองตัวที่ทำงานแยกกันกำลังอัปเดตแผน DNS เดียวกัน ตัวหนึ่งทำงานล่าช้า อีกตัวหนึ่งทำการอัปเดตเวอร์ชันใหม่กว่าเสร็จสมบูรณ์ จากนั้นขั้นตอนการล้างข้อมูลจะลบข้อมูลที่ตัวที่ทำงานล่าช้าเพิ่งเปิดใช้งานออกไป ส่วนประกอบแต่ละส่วนอาจดูเหมือนทำงานได้ตามที่ออกแบบไว้ แต่การทำงานร่วมกันของพวกมันทำให้เกิดสถานะที่ไม่ถูกต้อง
เหตุการณ์ AWS DynamoDB ปี 2025 แสดงให้เห็นถึงปัญหานี้ได้อย่างชัดเจน AWS ระบุว่าสาเหตุของความล้มเหลวเกิดจากสภาวะการแข่งขันแฝงระหว่างส่วนประกอบการจัดการ DNS ที่ซ้ำซ้อน ความสำคัญของเรื่องนี้กว้างกว่าแค่ผู้จำหน่ายรายเดียว: การสำรองข้อมูลจะช่วยเพิ่มความน่าเชื่อถือได้ก็ต่อเมื่อส่วนประกอบที่ซ้ำซ้อนเหล่านั้นไม่สามารถทำให้สถานะที่ใช้ร่วมกันเสียหายผ่านตรรกะเดียวกันหรือความล้มเหลวในการซิงโครไนซ์ได้
บริการอาจเปิดใช้งานได้อย่างสมบูรณ์ แต่ก็ยังใช้งานไม่ได้อย่างมีประสิทธิภาพหากลูกค้าไม่สามารถระบุชื่อโฮสต์ได้ หรือแพ็กเก็ตไม่สามารถเข้าถึงได้ ดังนั้น DNS, การกำหนดเส้นทาง, การกระจายโหลด และการกำหนดค่าเครือข่ายจึงเป็นส่วนสำคัญในผลิตภัณฑ์คลาวด์เกือบทุกประเภท
ในตัวอย่างของ Northstar ลูกค้าอาจเข้าใจผิดว่าบริการประมวลผลล้มเหลวเนื่องจากการเรียกใช้ API หมดเวลา แต่ในความเป็นจริงแล้วเซิร์ฟเวอร์ประมวลผลอาจยังทำงานได้ดีอยู่ แม้ว่า DNS จะไม่แสดงปลายทางที่ใช้งานได้ เส้นทางหายไป หรือตัวจัดการโหลดได้ลบเป้าหมายที่ทำงานได้ดีออกไปแล้วก็ตาม
AWS ได้บันทึกข้อผิดพลาดลักษณะนี้ไว้หลายครั้งแล้ว ในเหตุการณ์ที่เกิดขึ้นในภูมิภาคโซลเมื่อปี 2018 AWS ระบุว่าการอัปเดตการกำหนดค่าได้ลบการตั้งค่าที่ระบุจำนวนโฮสต์ที่ใช้งานได้ขั้นต่ำสำหรับกลุ่มตัวแก้ไข DNS ของ EC2 ออกไปโดยไม่ถูกต้อง ส่งผลให้ความจุของตัวแก้ไขลดลงและทำให้การสืบค้น DNS จากอินสแตนซ์ EC2 ล้มเหลว รายละเอียดอยู่ในบทสรุปของ AWS เกี่ยวกับปัญหาการแก้ไข DNS ของ EC2 ในโซลเมื่อปี 2018
ความล้มเหลวของเครือข่ายยังขยายวงกว้างอย่างรวดเร็วเนื่องจากแอปพลิเคชันจะพยายามเชื่อมต่อใหม่อีกครั้ง พฤติกรรมการลองเชื่อมต่อใหม่ที่รวดเร็วและมากเกินไปอาจทำให้ความบกพร่องของเครือข่ายเพียงบางส่วนกลายเป็นปริมาณการรับส่งข้อมูลที่เพิ่มขึ้นอย่างมาก
บริการคลาวด์ไม่ใช่ผลิตภัณฑ์ที่แยกออกจากกันโดยสิ้นเชิง ฐานข้อมูลแบบจัดการอาจขึ้นอยู่กับบริการยืนยันตัวตน ระบบ DNS ภายใน ระบบจัดเก็บข้อมูล ระบบเครือข่าย ระบบการจัดตารางเวลา บริการใบรับรอง และระบบวัดระยะทาง แพลตฟอร์มแบบไร้เซิร์ฟเวอร์อาจขึ้นอยู่กับความสามารถในการประมวลผล ระบบเครือข่าย ระบบคิว และฐานข้อมูลควบคุม หากส่วนประกอบที่ใช้ร่วมกันอย่างใดอย่างหนึ่งล้มเหลว ผลิตภัณฑ์หลายอย่างก็อาจทำงานผิดปกติไปพร้อมกันได้
นี่คือคำอธิบายของอาการขัดข้องที่สร้างความสับสนมากที่สุดอย่างหนึ่ง: ลูกค้าเห็นข้อผิดพลาดในหลายบริการและสันนิษฐานว่าเกิดความล้มเหลวหลายอย่างแยกกัน ในความเป็นจริง ความล้มเหลวที่มองเห็นได้อาจมีสาเหตุเดียวกันจากต้นทาง
ในสถานการณ์จำลองของ Northstar บริการเครื่องเสมือน บริการคอนเทนเนอร์ และบริการไร้เซิร์ฟเวอร์ อาจเริ่มล้มเหลวทั้งหมด เนื่องจากบริการเหล่านี้พึ่งพาฐานข้อมูลทรัพยากรภายในเดียวกัน ผลิตภัณฑ์ที่ลูกค้าใช้งานนั้นแตกต่างกัน แต่การพึ่งพาที่อยู่เบื้องหลังนั้นไม่แตกต่างกัน
เหตุการณ์ AWS ในเดือนตุลาคม 2025 แสดงให้เห็นถึงผลกระทบแบบลูกโซ่นี้ เมื่อบริการภายในที่พึ่งพา DynamoDB ได้รับผลกระทบจากปัญหา DNS ในตอนแรก ตามมาด้วยผลกระทบในการกู้คืนระบบในส่วนอื่นๆ เช่น EC2, Network Load Balancer, Lambda, บริการคอนเทนเนอร์, ฟังก์ชันที่เกี่ยวข้องกับข้อมูลประจำตัว และผลิตภัณฑ์อื่นๆ
การกู้คืนส่วนประกอบที่ผิดพลาดดั้งเดิมไม่ได้หมายความว่าปัญหาการหยุดชะงักจะสิ้นสุดลงเสมอไป ในช่วงเวลาที่ระบบหยุดทำงาน คิวจะเพิ่มขึ้น สัญญาเช่าหมดอายุ การตรวจสอบสถานะล้มเหลว ระบบปรับขนาดอัตโนมัติร้องขอความจุทดแทน ลูกค้าพยายามส่งคำขอซ้ำ และการอัปเดตการกำหนดค่าจะสะสมมากขึ้น เมื่อส่วนประกอบที่ล้มเหลวกลับมาทำงาน ระบบที่รออยู่ทั้งหมดอาจพยายามกู้คืนพร้อมกัน
ในตัวอย่างของ Northstar สมมติว่า DNS ได้รับการแก้ไขในเวลา 10:45 น. โฮสต์ประมวลผลหลายพันเครื่องจะพยายามต่ออายุสัญญาเช่าที่หมดอายุ ในขณะเดียวกัน ลูกค้าจะลองใช้งานระบบที่ล้มเหลวอีกครั้ง และระบบปรับขนาดอัตโนมัติจะร้องขออินสแตนซ์ทดแทน ระนาบควบคุมจึงต้องประมวลผลปริมาณงานมากกว่าปกติหลายเท่า หากไม่มีการจำกัดอัตราหรือการจัดลำดับความสำคัญในการกู้คืนที่มีประสิทธิภาพ ระบบอาจเข้าสู่โหมดความล้มเหลวครั้งที่สองได้ แม้ว่าข้อผิดพลาดเดิมจะหายไปแล้วก็ตาม
AWS เคยอธิบายถึงปัญหาการกู้คืนที่คล้ายคลึงกันในปี 2025 ว่า หลังจากที่การเข้าถึง DynamoDB กลับมาใช้งานได้อีกครั้ง ระบบย่อย EC2 ต้องสร้างสัญญาเช่าจำนวนมากขึ้นมาใหม่ งานที่ค้างอยู่กลายเป็นเรื่องที่ยากต่อการประมวลผลก่อนที่จะหมดเวลา และ AWS กล่าวว่าระบบย่อยดังกล่าวเข้าสู่สภาวะ "การล่มสลายเนื่องจากความแออัด" รายละเอียดนี้มีความสำคัญเพราะแสดงให้เห็นว่าเหตุใดระยะเวลาการหยุดชะงักจึงอาจยาวนานกว่าเวลาที่จำเป็นในการแก้ไขปัญหาที่เป็นสาเหตุเริ่มต้น
การตรวจสอบสุขภาพเครือข่ายมีความสำคัญอย่างยิ่ง แต่ก็เป็นระบบตัดสินใจอัตโนมัติเช่นกัน หากเครือข่ายทำงานช้าหรือการส่งต่อสถานะล่าช้า ระบบตรวจสอบสุขภาพอาจสรุปว่าทรัพยากรที่ใช้งานได้ปกติกลับมีปัญหาและตัดออกจากระบบ ซึ่งอาจลดความจุลงไปอีก ทำให้เกิดวงจรป้อนกลับ
ในสถานการณ์สมมติ ตัวจัดการโหลดของ Northstar เริ่มตรวจสอบอินสแตนซ์ที่เพิ่งเปิดใช้งานก่อนที่การกำหนดค่าเครือข่ายจะแพร่กระจายอย่างสมบูรณ์ การตรวจสอบล้มเหลว อินสแตนซ์ที่ทำงานได้ปกติถูกถอนออก การรับส่งข้อมูลถูกย้ายไปยังโหนดที่เหลืออยู่น้อยลง และโหนดเหล่านั้นก็โอเวอร์โหลด
รูปแบบดังกล่าวปรากฏขึ้นอีกครั้งในงาน AWS ปี 2025 โดย AWS กล่าวว่า การตรวจสอบสถานะของ Network Load Balancer บางครั้งล้มเหลวในขณะที่สถานะเครือข่ายสำหรับอินสแตนซ์ใหม่ยังคงแพร่กระจายอยู่ ซึ่งนำไปสู่การลดกำลังการผลิตลง นี่เป็นการเตือนว่าตรรกะการสลับระบบเมื่อเกิดข้อผิดพลาดจะต้องมีการจำกัดอัตราและทดสอบภายใต้ความล้มเหลวบางส่วน ไม่ใช่แค่ภายใต้สภาวะ "ปกติ/ผิดปกติ" ที่ชัดเจนเท่านั้น
ไม่ใช่ว่าทุกปัญหาจะเริ่มต้นจากซอฟต์แวร์เสมอไป ระบบไฟฟ้า ระบบระบายความร้อน ใยแก้วนำแสง ฮาร์ดแวร์เครือข่าย และโครงสร้างพื้นฐานทางกายภาพอื่นๆ ก็อาจล้มเหลวได้เช่นกัน สถาปัตยกรรมคลาวด์ถูกออกแบบมาโดยคำนึงถึงความเป็นจริงนี้ ซึ่งเป็นเหตุผลที่ผู้ให้บริการรายใหญ่แบ่งภูมิภาคออกเป็นโซนที่แยกจากกันเพื่อป้องกันความผิดพลาด
ไมโครซอฟต์อธิบายว่า Azure Availability Zones คือกลุ่มของศูนย์ข้อมูลที่แยกจากกัน โดยมีระบบไฟฟ้า ระบบระบายความร้อน และระบบเครือข่ายที่เป็นอิสระ ไมโครซอฟต์ยังระบุด้วยว่า การใช้งานแบบแบ่งโซนจะไม่คงอยู่โดยอัตโนมัติหากโซนใดโซนหนึ่งขัดข้อง ลูกค้าต้องใช้หลายโซนหรือบริการสำรองแบบแบ่งโซนหากได้รับการสนับสนุน ดูภาพรวม Azure Availability Zones อย่างเป็นทางการของไมโครซอฟต์ได้ ที่ นี่
ในทางปฏิบัติ ผู้ให้บริการคลาวด์สามารถทำให้โซนเป็นอิสระได้ แต่เวิร์กโหลดของลูกค้าอาจยังคงมีฐานข้อมูลในโซนเดียว การพึ่งพาการควบคุมระดับภูมิภาคเดียว หรือกระบวนการเฟลโอเวอร์ที่ไม่เคยถูกใช้งานมาก่อน
คำว่า “ระบบล่มทั่วโลก” มักหมายถึงผลกระทบต่อลูกค้า ไม่ใช่ตำแหน่งที่ตั้งของอุปกรณ์ที่เสียหาย บริการระดับภูมิภาคอาจรองรับการตรวจสอบสิทธิ์ DNS เมตาเดต้า กระบวนการสร้างแดชบอร์ด หรือ API ควบคุมที่ใช้จากภูมิภาคอื่น ดังนั้นแอปพลิเคชันทั่วโลกจึงอาจล้มเหลวได้เนื่องจากขึ้นอยู่กับบริการที่กระจุกตัวอยู่ในที่เดียว
ความแตกต่างนี้มีความสำคัญเมื่อทำการวินิจฉัยเหตุการณ์ วิศวกรควรตั้งคำถามสองข้อที่แตกต่างกัน: ความล้มเหลวครั้งแรกเกิดขึ้นที่ใด?และปัจจัยใดบ้างที่ทำให้ความล้มเหลวนั้นลุกลาม?คำตอบของทั้งสองคำถามมักจะแตกต่างกัน
สำหรับผู้ดูแลระบบ วิธีที่เร็วที่สุดมักจะเป็นการเชื่อมโยงอาการต่างๆ เข้าด้วยกันมากกว่าการตรวจสอบแต่ละผลิตภัณฑ์แยกกัน หากบริการหลายอย่างล้มเหลวในเวลาเดียวกัน ให้มองหาความสัมพันธ์ร่วมกัน หากเวิร์กโหลดที่มีอยู่ยังคงทำงานได้ดีในขณะที่การติดตั้งใหม่ล้มเหลว ให้สงสัยว่ามีปัญหาที่ระบบควบคุม การจัดตารางเวลา ความจุ หรือการจัดสรรทรัพยากร หากการเชื่อมต่อ IP ทำงานได้ แต่ชื่อบริการล้มเหลว ให้ตรวจสอบ DNS หากอัตราข้อผิดพลาดเพิ่มขึ้นหลังจากประกาศการกู้คืน ให้มองหาปัญหาการลองใหม่ซ้ำๆ การค้างงาน สัญญาเช่าหมดอายุ วงจรป้อนกลับการตรวจสอบสถานะ หรือความจุในการกู้คืนไม่เพียงพอ
ระบบแสดงสถานะของผู้ให้บริการยังสามารถช่วยแยกแยะเหตุการณ์ที่เกิดขึ้นกับแพลตฟอร์มออกจากความผิดพลาดเฉพาะแอปพลิเคชันได้ ตัวอย่างเช่น Google Cloud เผยแพร่เหตุการณ์ปัจจุบันและเหตุการณ์ในอดีตผ่านแดชบอร์ด Service Health อย่างเป็นทางการในขณะที่ AWS เผยแพร่สรุปเหตุการณ์สำคัญผ่านทางPost-Event Summaries อย่างเป็นทางการ
ไม่มีสถาปัตยกรรมใดที่รับประกันได้ว่าระบบจะไม่หยุดทำงานเลย แต่การออกแบบหลายอย่างจะช่วยลดความเสี่ยงได้ ใช้โซนความพร้อมใช้งานหลายแห่งสำหรับเวิร์กโหลดการผลิตเมื่อบริการรองรับ สำหรับเวิร์กโหลดที่ไม่สามารถทนต่อการหยุดทำงานในระดับภูมิภาคได้ ให้ประเมินการออกแบบหลายภูมิภาคและทำความเข้าใจข้อแลกเปลี่ยนระหว่างความสอดคล้องของข้อมูล กำจัดจุดล้มเหลวเดี่ยวที่ซ่อนอยู่ เช่น บริการระบุตัวตนระดับภูมิภาคหนึ่งแห่ง เส้นทาง DNS หนึ่งแห่ง หรือ API การจัดการหนึ่งแห่งที่การดำเนินการกู้คืนทุกอย่างขึ้นอยู่กับ
แอปพลิเคชันควรสามารถรับมือกับความล้มเหลวได้อย่างราบรื่น ซึ่งอาจหมายถึงการให้บริการเนื้อหาที่แคชไว้ การจัดคิวการเขียนข้อมูลที่ไม่สำคัญ การจำกัดการลองใหม่ด้วยการหน่วงเวลาแบบทวีคูณและการกระเพื่อม การแยกการทำงานของส่วนควบคุมออกจากการรับส่งข้อมูล และการรักษาโหมด "อ่านอย่างเดียว" หรือ "ธุรกรรมหลัก" ที่ลดลงในระหว่างการหยุดทำงานบางส่วน ควรทดสอบขั้นตอนการกู้คืนภายใต้สภาวะที่มีคำขอค้างอยู่ เนื่องจาก1การเริ่มต้นการทำงานของส่วนประกอบในสภาพแวดล้อมการทดสอบที่ว่างเปล่าแตกต่างอย่างมากจากการกู้คืนในขณะที่มีคำขอรออยู่หลายล้านรายการ
กลับมาที่สถานการณ์ของ Northstar Cloud อีกครั้ง การเปลี่ยนแปลงการกำหนดค่าเวลา 10:05 น. อาจเป็นตัวกระตุ้น แต่ไม่ใช่คำอธิบายทั้งหมด การหยุดชะงักแพร่กระจายในวงกว้างเนื่องจากเครือข่ายมีการใช้งานร่วมกัน ระบบอัตโนมัติมีข้อบกพร่องด้านเวลา บริการปลายทางขึ้นอยู่กับสถานะเดียวกัน การตรวจสอบสถานะลดความจุ การลองใหม่เพิ่มภาระ และระบบกู้คืนต้องประมวลผลข้อมูลที่ค้างอยู่จำนวนมาก
นั่นคือรูปแบบหลักที่อยู่เบื้องหลังเหตุการณ์ระบบคลาวด์ครั้งใหญ่หลายครั้ง: ความล้มเหลวที่เริ่มต้นมักมีขนาดเล็กเมื่อเทียบกับห่วงโซ่การพึ่งพาที่ขยายใหญ่ขึ้นดังนั้น การทำความเข้าใจเกี่ยวกับการหยุดทำงานของระบบคลาวด์จึงหมายถึงการตรวจสอบทั้งสาเหตุหลักและการแพร่กระจาย การออกแบบที่ยืดหยุ่นที่สุดจะตั้งสมมติฐานว่าส่วนประกอบแต่ละส่วนจะล้มเหลว และมุ่งเน้นไปที่การป้องกันไม่ให้ความล้มเหลวเหล่านั้นกลายเป็นเหตุการณ์ที่ส่งผลกระทบต่อทั้งระบบ
เปรียบเทียบ Collabora Online และ ONLYOFFICE Docs บนเซิร์ฟเวอร์เดียวกัน โดยใช้การทดสอบที่ทำซ้ำได้เพื่อวัดการใช้หน่วยความจำ เวลาในการเปิดเอกสาร และความล่าช้าในการแก้ไขร่วมกัน
เปรียบเทียบพฤติกรรมการจัดการเอกสาร สเปรดชีต และเค้าโครงใน ONLYOFFICE Docs และแอปพลิเคชันเว็บ Microsoft 365 จากนั้นใช้การทดสอบอย่างรวดเร็วเพื่อเลือกโปรแกรมแก้ไขที่ปลอดภัยกว่าสำหรับไฟล์ของคุณ
ตรวจสอบความผิดพลาดของสูตรว่าเกิดจากไวยากรณ์ ตัวคั่นภูมิภาค การคำนวณซ้ำ ระบบวันที่ หรือฟังก์ชันที่ไม่รองรับ จากนั้นตรวจสอบสมุดงานอีกครั้งก่อนที่จะแชร์
ดูว่าข้อมูลเวอร์ชันล่าสุดสามารถพิสูจน์อะไรได้บ้าง และพิสูจน์อะไรไม่ได้บ้าง จากนั้นเปรียบเทียบชุดโปรแกรมสำนักงานทั้งสองชุดบนไฟล์และคอมพิวเตอร์เครื่องเดียวกัน
เปรียบเทียบการจับคู่ที่ตรงกันทุกประการ การค้นหาด้านซ้าย การจัดการค่าที่หายไป และการรองรับเวอร์ชัน เพื่อให้คุณสามารถเลือกสูตร Calc ที่เชื่อถือได้
เรียนรู้วิธีที่รูปแบบหน้ากระดาษของ Writer และลิงก์ส่วนต่างๆ ใน Word ส่งผลต่อหน้าปก เลขโรมัน และการเริ่มต้นหมายเลขใหม่เมื่อคุณย้ายเอกสาร
เปรียบเทียบ Pardus Software Center กับคำสั่ง APT เพื่อค้นหา ติดตั้ง ลบ และอัปเดตแพ็กเกจโดยใช้วิธีที่เหมาะสมกับงานของคุณ
ดูว่าข้อกำหนดด้าน RAM ที่ Pardus เผยแพร่นั้นหมายความว่าอย่างไร จากนั้นเปรียบเทียบ XFCE และ GNOME บนพีซีเครื่องเดียวกัน โดยใช้ค่า MemAvailable ที่สามารถวัดซ้ำได้
ดูว่า HamoniKR 8.0 เหมาะกับแผนเดสก์ท็อปสำหรับธุรกิจอย่างไร รองรับฟีเจอร์ใดบ้างที่เน้นตลาดเกาหลี และควรตรวจสอบอะไรบ้างก่อนการเปิดตัวในวงกว้าง
ทำความเข้าใจว่าการตรวจสอบการบูตและการป้องกันขณะทำงานของ Gooroom ทำงานร่วมกันอย่างไร ความหมายของ "แซนด์บ็อกซ์" และการตั้งค่าใดที่คุณควรตรวจสอบบนอุปกรณ์ของคุณ






