คำตอบโดยย่อ: ความก้าวหน้าของ AI ในปัจจุบันมาจากระบบเซมิคอนดักเตอร์ทั้งหมด
ฮาร์ดแวร์ AI และซูเปอร์คอมพิวเตอร์รุ่นต่อไปไม่ได้ขับเคลื่อนด้วยความก้าวหน้าเพียงอย่างเดียว แต่สร้างขึ้นจากเทคโนโลยีหลายอย่างที่ต้องทำงานร่วมกัน ได้แก่ ทรานซิสเตอร์แบบเกตออลอะราวด์ ระบบจ่ายไฟด้านหลัง สถาปัตยกรรมชิปเล็ต บรรจุภัณฑ์ขั้นสูง หน่วยความจำแบนด์วิดท์สูง การเชื่อมต่อระหว่างชิปที่เร็วขึ้น และเครือข่ายใยแก้วนำแสงที่เพิ่มมากขึ้น ผลลัพธ์ที่ได้คือ พลังการประมวลผลที่มากขึ้น แบนด์วิดท์หน่วยความจำที่มากขึ้น และการขยายขนาดที่ดีขึ้นโดยไม่ต้องพึ่งพาขนาดของทรานซิสเตอร์ที่เล็กลงเพียงอย่างเดียว
เรื่องนี้สำคัญเพราะตัวเร่งความเร็ว AI สมัยใหม่และซูเปอร์คอมพิวเตอร์ทางวิทยาศาสตร์มักประสบปัญหาเรื่องข้อจำกัดด้านการเคลื่อนย้ายข้อมูลและพลังงานก่อนที่จะหมดความสามารถในการคำนวณทางคณิตศาสตร์ เครื่องมือคำนวณเมทริกซ์ที่เร็วขึ้นจะมีประโยชน์ก็ต่อเมื่อน้ำหนักของแบบจำลอง ค่าแอคติเวชัน และผลลัพธ์ระดับกลางสามารถเข้าถึงเครื่องมือได้อย่างรวดเร็วเพียงพอ เช่นเดียวกัน การเพิ่มตัวเร่งความเร็วมากขึ้นจะมีประโยชน์ก็ต่อเมื่อแพ็กเกจ เครือข่ายแร็ค ระบบหน่วยความจำ ระบบระบายความร้อน และซอฟต์แวร์สามารถรองรับการทำงานของเครื่องมือเหล่านั้นได้อย่างเต็มที่
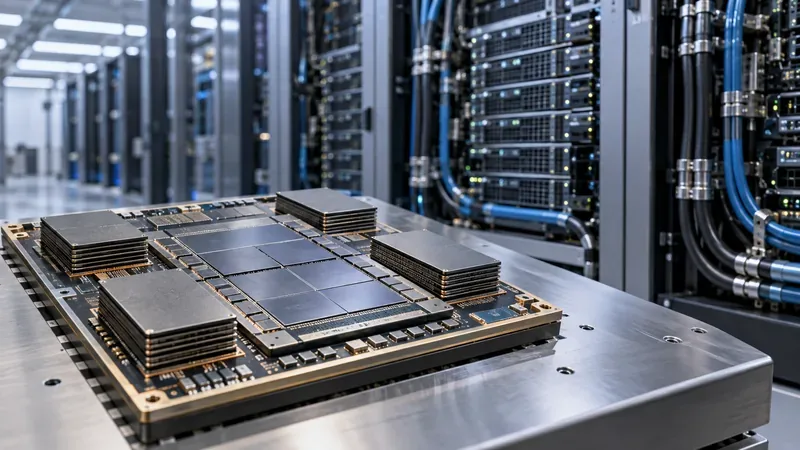
โมดูลเร่งความเร็วแบบหลายชิปที่มีแพ็คเกจหน่วยความจำเรียงซ้อนกันหลายชั้น แสดงให้เห็นถึงทิศทางของฮาร์ดแวร์ AI สมัยใหม่ นั่นคือ การประมวลผล หน่วยความจำ บรรจุภัณฑ์ การจ่ายพลังงาน และการระบายความร้อน ถูกออกแบบให้เป็นระบบเดียวกันมากขึ้นเรื่อยๆ
1. โครงสร้างทรานซิสเตอร์แบบใหม่ช่วยเพิ่มประสิทธิภาพ แต่เป็นเพียงจุดเริ่มต้นเท่านั้น
เทคโนโลยีลอจิกชั้นนำกำลังก้าวข้ามโครงสร้าง FinFET ที่ครอบงำชิปขั้นสูงมานานหลายปีแล้ว การออกแบบแบบ Gate-all-around หรือ GAA นั้น จะห่อหุ้มเกตไว้รอบแผ่นนาโนหรือโครงสร้างช่องสัญญาณที่คล้ายกัน ทำให้ผู้ออกแบบชิปสามารถควบคุมไฟฟ้าสถิตได้แน่นขึ้นเมื่อขนาดของชิปเล็ลง ซึ่งสามารถปรับปรุงประสิทธิภาพ ลดการรั่วไหล หรือสร้างสมดุลที่ดีขึ้นระหว่างทั้งสองอย่างได้
TSMC ระบุว่ากระบวนการผลิต N2 ขนาด 2 นาโนเมตรของบริษัทได้เริ่มผลิตในปริมาณมากในไตรมาสที่สี่ของปี 2025 ในขณะที่เทคโนโลยี A16 ของบริษัทได้รวมทรานซิสเตอร์แบบนาโนชีทเข้ากับรางจ่ายไฟด้านหลัง โดยมีเป้าหมายเฉพาะสำหรับผลิตภัณฑ์คอมพิวเตอร์ประสิทธิภาพสูงที่มีความต้องการการจ่ายพลังงานสูง TSMC กล่าวว่าการผลิต A16 ในปริมาณมากมีกำหนดไว้ในช่วงครึ่งหลังของปี 2026 ดูรายละเอียดเพิ่มเติมได้ที่หน้าเทคโนโลยี A16 ของโรงงานผลิต และรายงานประจำปี 2025
อินเทลกำลังเดินไปในทิศทางที่คล้ายคลึงกันด้วยเทคโนโลยี Intel 18A กระบวนการผลิตนี้ผสมผสานทรานซิสเตอร์ RibbonFET GAA เข้ากับระบบจ่ายไฟด้านหลัง PowerVia อินเทลรายงานว่า 18A เริ่มเข้าสู่กระบวนการผลิตจริงในปี 2025 ในขณะที่รุ่นปรับปรุง 18A-P เริ่มเข้าสู่กระบวนการผลิตทดลองในเดือนมิถุนายน 2026 อินเทลยังเผยแพร่ข้อมูลประสิทธิภาพ การใช้พลังงาน และความหนาแน่นเปรียบเทียบสำหรับเทคโนโลยีนี้ด้วย ตัวเลขเหล่านั้นเป็นข้อมูลที่ผู้ผลิตรายงานและควรได้รับการตรวจสอบกับแบบจำลองเฉพาะมากกว่าที่จะนำมาใช้เป็นข้อได้เปรียบในระดับชิปโดยทั่วไป รายละเอียดปัจจุบันสามารถดูได้ที่หน้าเว็บกระบวนการผลิต 18A ของ อินเทล
การจ่ายไฟไปไว้ด้านหลังชิปมีความสำคัญ เนื่องจากชิปขั้นสูงต้องส่งทั้งสัญญาณและพลังงานผ่านสายไฟที่มีความหนาแน่นสูงมาก การย้ายส่วนหนึ่งของเครือข่ายการจ่ายไฟไปไว้ด้านหลังจะช่วยลดภาระทรัพยากรในการจัดเส้นทางสัญญาณและปรับปรุงการจ่ายแรงดันไฟฟ้า สำหรับตัวเร่งความเร็ว AI ซึ่งมีหน่วยประมวลผลจำนวนมากสลับการทำงานด้วยอัตราสูง การจ่ายไฟไปไว้ด้านหลังจึงมีความสำคัญไม่แพ้ความหนาแน่นของทรานซิสเตอร์เลย
2. ชิปเล็ตและเทคโนโลยีบรรจุภัณฑ์ขั้นสูงกำลังเปลี่ยนบรรจุภัณฑ์ให้กลายเป็นระบบประมวลผลขนาดเล็ก
ชิปแบบโมโนลิธิกนั้นยากและมีราคาแพงขึ้นในการขยายขนาดเมื่อมีขนาดใหญ่ขึ้น ชิปเล็ตจึงเป็นอีกทางเลือกหนึ่ง: สามารถผลิตฟังก์ชันแยกกันโดยใช้เทคโนโลยีการผลิตที่เหมาะสมที่สุด แล้วนำมารวมกันไว้ในแพ็คเกจเดียว ชิปประมวลผลอาจต้องการกระบวนการผลิตลอจิกที่ทันสมัยที่สุด ในขณะที่ชิปอินพุต/เอาต์พุต แคช วงจรอนาล็อก หรือฟังก์ชันอื่นๆ อาจไม่ต้องการเช่นนั้น
การออกแบบบรรจุภัณฑ์เป็นสิ่งที่ทำให้สิ่งนี้ใช้งานได้จริง ตัวอย่างเช่น แพลตฟอร์มบรรจุภัณฑ์ขั้นสูง CoWoS ของ TSMC ได้รับการออกแบบมาเพื่อรวมอุปกรณ์ลอจิกหลายตัวและหน่วยความจำแบนด์วิดท์สูงหลายชั้นไว้ในแพ็คเกจ 2.5D TSMC วางตำแหน่ง CoWoS โดยเฉพาะสำหรับผลิตภัณฑ์ AI และ HPC ซึ่งการเชื่อมต่อที่สั้นและกว้างระหว่างหน่วยประมวลผลและ HBM มีความสำคัญอย่างยิ่ง
มาตรฐานต่างๆ กำลังเกิดขึ้นเพื่อลดความเป็นกรรมสิทธิ์ของชิปเล็ตข้อกำหนด UCIe 3.0 ซึ่งเผยแพร่ในเดือนสิงหาคม 2025 รองรับอัตราการส่งข้อมูล 48 GT/s และ 64 GT/s และเพิ่มคุณสมบัติเพื่อประสิทธิภาพด้านพลังงาน การจัดการ และระบบมัลติชิปที่ยืดหยุ่นมากขึ้น UCIe ไม่ได้ทำให้ชิปเล็ตสามารถใช้งานทดแทนกันได้ในชั่วข้ามคืน แต่ให้กรอบการทำงานทางไฟฟ้าและโปรโตคอลทั่วไปสำหรับลิงก์ภายในแพ็กเกจแก่ภาคอุตสาหกรรม
แนวทางนี้มีความน่าสนใจเป็นพิเศษเมื่อบริษัทต้องการสร้างตัวเร่งความเร็วหลายรุ่นจากส่วนประกอบที่นำกลับมาใช้ใหม่ได้ แต่จะมีความน่าสนใจน้อยลงเมื่อต้นทุนด้านบรรจุภัณฑ์ ความหนาแน่นของความร้อน หรือความซับซ้อนของการออกแบบมีมากกว่าประโยชน์ด้านความยืดหยุ่น ผลิตภัณฑ์ขนาดเล็กที่มีความต้องการหน่วยความจำและอินพุต/เอาต์พุตไม่มากนัก อาจจะเหมาะสมกว่าหากใช้ตัวอุปกรณ์แบบโมโนลิธิกที่เรียบง่ายกว่า
3. หน่วยความจำแบนด์วิดท์สูงกำลังกลายเป็นสิ่งสำคัญไม่แพ้ตัวเร่งความเร็วเอง
ภาระงาน AI นั้นมีการย้ายเทนเซอร์ขนาดใหญ่ระหว่างหน่วยความจำและหน่วยประมวลผลซ้ำๆ ซึ่งทำให้แบนด์วิดท์ของหน่วยความจำกลายเป็นข้อจำกัดในการออกแบบลำดับแรก หน่วยความจำแบนด์วิดท์สูง หรือ HBM แก้ปัญหานี้โดยการซ้อนชิป DRAM และวางไว้ใกล้กับตัวเร่งความเร็วผ่านอินเทอร์เฟซที่กว้างมาก
ปัจจุบัน HBM4 กำลังเปลี่ยนจากแผนงานไปสู่ระบบเชิงพาณิชย์แล้ว ซัมซุงประกาศการจัดส่ง HBM4 เชิงพาณิชย์ในเดือนกุมภาพันธ์ 2026 และระบุว่าผลิตภัณฑ์เข้าสู่การผลิตจำนวนมากด้วยอัตราการถ่ายโอนข้อมูลที่คงที่ 11.7 Gb/s และมีความสามารถสูงสุดถึง 13 Gb/s ในเดือนพฤษภาคม 2026 ซัมซุงยังประกาศการจัดส่งตัวอย่าง HBM4E อีกด้วย รายละเอียดเหล่านี้มีอยู่ในประกาศการผลิต HBM4 ของ ซัมซุง
บริษัท SK hynix ระบุในผลประกอบการไตรมาสที่สองปี 2026 ว่าได้เริ่มจัดส่ง HBM4 จำนวนมากในช่วงไตรมาสนี้ และวางแผนที่จะเพิ่มกำลังการผลิตในช่วงครึ่งหลังของปี นอกจากนี้ บริษัทยังได้จัดส่งตัวอย่าง HBM4E แบบ 12 ชั้นแล้ว โปรดดูผลประกอบการไตรมาสที่ 2 ปี 2026 ของ SK hynix สำหรับสถานะปัจจุบัน
ทำไมเรื่องนี้ถึงสำคัญในทางปฏิบัติ? ข้อมูลจำเพาะปัจจุบันของ NVIDIA Vera Rubin ระบุว่ามีหน่วยความจำ HBM4 ขนาด 288 GB บน GPU Rubin หนึ่งตัว และแบนด์วิดท์หน่วยความจำ GPU 19.2 TB/s ในขณะที่ตัวเร่งความเร็ว MI350 ซีรีส์ของ AMD ใช้ HBM3E โดย AMD ระบุว่ามีหน่วยความจำสูงสุด 288 GB และ 8 TB/s สำหรับ MI355X สถาปัตยกรรมแตกต่างกันและไม่ควรนำมาเปรียบเทียบกันจากตัวเลขแบนด์วิดท์เพียงอย่างเดียว แต่ทั้งสองแสดงให้เห็นว่าความจุของหน่วยความจำและแบนด์วิดท์เป็นข้อมูลจำเพาะหลักของตัวเร่งความเร็วในปัจจุบัน ไม่ใช่รายละเอียดรองอีกต่อไป ดูข้อมูลจำเพาะอย่างเป็นทางการของ NVIDIA Vera Rubin NVL72 และหน้าเว็บ AMD Instinct MI350 Series ได้ ที่นี่
4. การเชื่อมต่อแบบขยายขนาดขึ้นและขยายขนาดออก จะเป็นตัวกำหนดว่าตัวเร่งความเร็วหลายตัวจะทำงานเหมือนตัวเดียวหรือไม่
แบบจำลองขนาดใหญ่และการจำลองทางวิทยาศาสตร์มักไม่สามารถประมวลผลได้อย่างครบถ้วนบนอุปกรณ์เพียงเครื่องเดียว ระบบจึงต้องแบ่งงานไปยังตัวเร่งความเร็วหลายตัวและแลกเปลี่ยนผลลัพธ์บางส่วนอยู่บ่อยครั้ง หากการสื่อสารช้า หน่วยประมวลผลที่มีราคาแพงก็จะไม่ได้ใช้งาน
นั่นคือเหตุผลที่เครือข่ายขยายขนาดที่เป็นกรรมสิทธิ์กำลังพัฒนาควบคู่ไปกับ GPU เอง แพลตฟอร์ม Rubin ของ NVIDIA ใช้ NVLink รุ่นที่หก โดย NVIDIA ระบุว่ามีแบนด์วิดท์ NVLink 3 TB/s ต่อ GPU ของ Rubin และ 216 TB/s ในระบบ NVL72 AMD ใช้ Infinity Fabric ในแพลตฟอร์มเร่งความเร็วของตน สำหรับผู้ซื้อ คำถามสำคัญไม่ได้อยู่ที่แบนด์วิดท์ลิงก์สูงสุดเท่านั้น แต่ยังอยู่ที่ว่าเครือข่ายทำงานอย่างไรภายใต้การทำงานแบบรวมกลุ่ม รูปแบบขนานโมเดล และโทโพโลยีที่แอปพลิเคชันใช้งาน
ในระดับหน่วยความจำระบบ Compute Express Link ก็มีการพัฒนาเช่นกันกลุ่มพันธมิตร CXL กล่าวว่า CXL 4.0 เพิ่มความเร็วในการส่งสัญญาณเป็นสองเท่าจาก 64 GT/s เป็น 128 GT/s เพิ่มพอร์ตแบบรวมกลุ่ม และขยายคุณสมบัติความน่าเชื่อถือของหน่วยความจำ CXL มีความสำคัญเมื่อสถาปนิกต้องการขยายหน่วยความจำ การรวมกลุ่ม หรือการแยกส่วนหน่วยความจำอย่างสอดคล้องกัน โดยไม่ต้องมองแต่ละระดับของหน่วยความจำเป็นอุปกรณ์จัดเก็บข้อมูลระยะไกล
5. เทคโนโลยีโฟโตนิกส์ซิลิคอนกำลังก้าวเข้าใกล้ซิลิคอนสวิตช์มากขึ้น
สายทองแดงยังคงเป็นตัวเลือกที่ยอดเยี่ยมสำหรับการเชื่อมต่อทางไฟฟ้าที่มีระยะทางสั้นและหนาแน่น แต่การเชื่อมต่อด้วยใยแก้วนำแสงกลับมีความน่าสนใจมากขึ้นเรื่อยๆ เมื่อระยะทางและแบนด์วิดท์โดยรวมเพิ่มขึ้น ขั้นตอนสำคัญต่อไปคือการออกแบบระบบใยแก้วนำแสงแบบรวมแพ็คเกจ (co-packaged optics) ซึ่งส่วนประกอบใยแก้วนำแสงจะถูกย้ายให้ใกล้กับชิป ASIC สำหรับเครือข่ายมากขึ้น แทนที่จะอยู่แต่ในตัวรับส่งสัญญาณแบบเสียบปลั๊กที่ขอบของสวิตช์
NVIDIA ระบุว่าแพลตฟอร์ม Spectrum-X Ethernet Photonics ของตนใช้ส่วนประกอบออปติกแบบรวมแพ็คเกจ และรายงานว่ามีประสิทธิภาพการใช้พลังงานในเครือข่ายดีกว่าการออกแบบตัวรับส่งสัญญาณแบบเสียบปลั๊กแบบดั้งเดิมถึง 5 เท่า นี่เป็นการเปรียบเทียบระหว่างผู้ผลิต ไม่ใช่การรับประกันสำหรับโครงสร้างเครือข่ายศูนย์ข้อมูลทุกรูปแบบ แต่เป็นการเน้นให้เห็นถึงทิศทางที่กำลังพัฒนา: การใช้พลังงานในเครือข่ายกำลังมีความสำคัญมากขึ้นจนการรวมส่วนประกอบออปติกกลายเป็นส่วนหนึ่งของการออกแบบระบบเซมิคอนดักเตอร์แล้ว ดูภาพรวมซิลิคอนโฟโตนิกส์ ของ NVIDIA ได้ที่ นี่
สิ่งนี้หมายความอย่างไรต่องานประมวลผล AI และซูเปอร์คอมพิวเตอร์ในทางปฏิบัติ
ภาระงาน คุณสมบัติของเซมิคอนดักเตอร์ที่ควรให้ความสำคัญ เหตุใดสิ่งเหล่านี้จึงสำคัญ
การฝึกฝนโมเดลขนาดใหญ่ล่วงหน้า ความจุและแบนด์วิดท์ของ HBM, ลิงก์ขยายขนาดได้อย่างรวดเร็ว, บรรจุภัณฑ์หนาแน่น, ระบบระบายความร้อนประสิทธิภาพสูง การฝึกอบรมเน้นหนักไปที่การเคลื่อนที่ของเทนเซอร์และการสื่อสารที่ประสานกันระหว่างตัวเร่งความเร็วหลายตัว บริบทระยะยาวและการอนุมานเชิงตัวแทน กลุ่มหน่วยความจำ HBM ขนาดใหญ่ การประมวลผลความแม่นยำต่ำที่มีประสิทธิภาพสูง แบนด์วิดท์การเชื่อมต่อสูง การจัดลำดับชั้นของหน่วยความจำ แคช KV และขั้นตอนการให้เหตุผลซ้ำๆ อาจทำให้ความจุของหน่วยความจำและการเคลื่อนย้ายข้อมูลมีข้อจำกัดมากกว่าประสิทธิภาพการประมวลผลสูงสุด (FLOPS) HPC ทางวิทยาศาสตร์ ความสามารถในการประมวลผล FP64, แบนด์วิดท์หน่วยความจำ, การเชื่อมต่อที่เชื่อถือได้, และไลบรารีเชิงตัวเลขที่พัฒนาแล้ว โค้ดจำลองมักอาศัยความแม่นยำสองเท่าและแบนด์วิดท์ที่ต่อเนื่องมากกว่าปริมาณการประมวลผลเทนเซอร์ที่มีความแม่นยำต่ำเพียงอย่างเดียว การอนุมานระดับองค์กร ประสิทธิภาพต่อวัตต์ ความเข้ากันได้ของซอฟต์แวร์ ขนาดหน่วยความจำที่เหมาะสม ตัวเลือกการใช้งาน PCIe ระบบที่ดีที่สุดอาจเป็นระบบที่เหมาะสมกับเซิร์ฟเวอร์และกำลังไฟที่มีอยู่แล้ว มากกว่าสถาปัตยกรรมแร็คที่มีความหนาแน่นสูงสุด ตัวเร่งความเร็วแบบกำหนดเอง กลยุทธ์ชิปเล็ต ระบบนิเวศบรรจุภัณฑ์ การสนับสนุน UCIe ความพร้อมของกระบวนการ การออกแบบแบบโมดูลาร์สามารถช่วยลดวงจรการนำกลับมาใช้ใหม่ได้ แต่ความซับซ้อนของบรรจุภัณฑ์และการตรวจสอบคุณสมบัติของห่วงโซ่อุปทานอาจลดทอนประโยชน์ดังกล่าวลงได้
ตัวอย่างที่เป็นรูปธรรม: เหตุใด GPU ที่เร็วขึ้นจึงไม่เพียงพอ
ลองพิจารณาถึงทีมที่ดูแลโมเดลภาษาขนาดใหญ่ที่มีหน้าต่างบริบทที่ยาว สมมติว่าการวิเคราะห์ประสิทธิภาพแสดงให้เห็นว่า GPU มักรอการถ่ายโอนข้อมูลในหน่วยความจำและการสื่อสารข้าม GPU การเปลี่ยนไปใช้ตัวเร่งความเร็วรุ่นใหม่กว่าอาจช่วยได้ แต่ก็ต่อเมื่อระบบใหม่นั้นมีหน่วยความจำ HBM ที่เพียงพอ แบนด์วิดท์หน่วยความจำที่เร็วกว่า และโครงสร้างเครือข่ายที่ช่วยลดการหยุดชะงักของการสื่อสาร การซื้ออุปกรณ์ที่มีประสิทธิภาพการประมวลผลเทนเซอร์ตามทฤษฎีสูงกว่า ในขณะที่ยังคงใช้หน่วยความจำและข้อจำกัดด้านเครือข่ายแบบเดิม อาจให้ผลลัพธ์ที่ดีกว่าที่สเปคหลักระบุไว้มาก
หลักการเดียวกันนี้ปรากฏในซูเปอร์คอมพิวเตอร์แบบดั้งเดิม ระบบ Frontier ของห้องปฏิบัติการแห่งชาติโอ๊คริดจ์ (Oak Ridge National Laboratory) ผสานรวมตัวเร่งความเร็ว AMD MI250X เข้ากับ HBM และระบบเชื่อมต่อความเร็วสูงคู่มือผู้ใช้ Frontier อธิบายวิธีการทำงานร่วมกันของหน่วยประมวลผล HBM การเชื่อมต่อ CPU-GPU และเครือข่าย Slingshot ฮาร์ดแวร์รุ่นนี้เก่ากว่าแพลตฟอร์ม AI รุ่นใหม่ล่าสุดในปี 2026 แต่บทเรียนด้านสถาปัตยกรรมยังคงใช้ได้อยู่ นั่นคือ ประสิทธิภาพการทำงานของแอปพลิเคชันอย่างต่อเนื่องขึ้นอยู่กับเส้นทางระหว่างหน่วยประมวลผล หน่วยความจำ และโหนดอื่นๆ
เมื่อใดที่ฮาร์ดแวร์เซมิคอนดักเตอร์รุ่นใหม่จึงคุ้มค่ากับการอัปเกรด?
การอัปเกรดจะคุ้มค่าที่สุดก็ต่อเมื่อสามารถแก้ไขปัญหาคอขวดที่วัดผลได้ แทนที่จะเป็นการเปลี่ยนชิ้นส่วนรุ่นเก่าเพียงอย่างเดียว ก่อนที่จะตัดสินใจเลือกใช้ตัวเร่งความเร็วรุ่นใหม่ ควรตรวจสอบสิ่งต่อไปนี้:
ปัญหาเรื่องหน่วยความจำ: โมเดลหรือการจำลองใช้หน่วยความจำของโฮสต์มากเกินไปหรือไม่ จำเป็นต้องมีการบันทึกสถานะอย่างละเอียดถี่ถ้วน หรือบังคับให้มีการแบ่งส่วนโมเดลในระดับที่ไม่สะดวกหรือไม่แรงกดดันด้านแบนด์วิดท์: เคอร์เนลติดขัดเรื่องหน่วยความจำในการวิเคราะห์ประสิทธิภาพหรือไม่ หรือตัวเร่งความเร็วใช้เวลาอย่างมีนัยสำคัญในการรอการดำเนินการ all-reduce และการดำเนินการแบบรวมกลุ่มอื่นๆ หรือไม่?กำลังไฟและการระบายความร้อน: แร็ค อุปกรณ์ และระบบระบายความร้อนสามารถรองรับความหนาแน่นของกำลังไฟใหม่ได้หรือไม่? ประสิทธิภาพที่สูงขึ้นอาจไม่เหมาะสมหากการอัพเกรดโครงสร้างพื้นฐานมีต้นทุนสูงกว่าส่วนอื่น ๆความพร้อมของซอฟต์แวร์: คอมไพเลอร์ ไลบรารี เคอร์เนล สแต็กการจัดการ และเครื่องมือตรวจสอบ มีความพร้อมสำหรับสถาปัตยกรรมใหม่หรือไม่?ข้อกำหนดด้านความแม่นยำ: ภาระงานสามารถใช้รูปแบบที่มีความแม่นยำต่ำได้อย่างปลอดภัยหรือไม่ หรือจำเป็นต้องใช้ FP64 หรือรูปแบบที่มีความแม่นยำสูงกว่านั้น?การใช้ประโยชน์: ปริมาณงานจะทำให้ฮาร์ดแวร์ใหม่ทำงานได้อย่างต่อเนื่องจนคุ้มค่ากับต้นทุนหรือไม่? ความจุที่ไม่ได้ใช้งานจะไม่คุ้มค่าทางเศรษฐกิจเพียงเพราะชิปเป็นรุ่นใหม่กว่า
การแลกเปลี่ยนผลประโยชน์เริ่มมีความเป็นรูปธรรมมากขึ้น
ความก้าวหน้าในด้านเซมิคอนดักเตอร์กำลังสร้างความสามารถที่น่าประทับใจ แต่ปัจจัยจำกัดก็ปรากฏชัดเจนมากขึ้นเรื่อยๆ แพ็คเกจขั้นสูงมีขนาดใหญ่ขึ้นและผลิตยากขึ้น ชุด HBM ทำให้เกิดความร้อนกระจุกตัวอยู่ใกล้กับวงจรลอจิกกำลังสูง ระบบขนาดแร็คอาจต้องการระบบระบายความร้อนด้วยของเหลว การกระจายพลังงานที่หนาแน่น และเครือข่ายเฉพาะทาง การรวมชิ้นส่วนออปติกไว้ในแพ็คเกจเดียวกันสามารถลดพลังงานของเครือข่ายได้ แต่ก็ทำให้เกิดข้อควรพิจารณาใหม่ๆ ในการผลิตและการบำรุงรักษา ชิปเล็ตสามารถปรับปรุงความเป็นโมดูลาร์ได้ แต่ก็เพิ่มงานด้านการตรวจสอบ การบรรจุภัณฑ์ และการจัดการผลผลิต
นอกจากนี้ยังมีข้อแลกเปลี่ยนในด้านซอฟต์แวร์ด้วย การคำนวณเลขคณิตความแม่นยำต่ำ เช่น FP8, FP6 หรือ FP4 สามารถเพิ่มประสิทธิภาพการประมวลผลของ AI ได้อย่างมาก แต่ซอฟต์แวร์ต้องรักษาคุณภาพของแบบจำลองไว้ รหัสทางวิทยาศาสตร์อาจไม่สามารถใช้ทางลัดแบบเดียวกันได้ คุณสมบัติของเซมิคอนดักเตอร์จะมีค่าก็ต่อเมื่อแอปพลิเคชันสามารถใช้ประโยชน์จากคุณสมบัตินั้นได้โดยไม่ละเมิดข้อกำหนดด้านความแม่นยำหรือความน่าเชื่อถือ
น่าดูอะไรต่อไป
สำหรับช่วงที่เหลือของปี 2026 และต่อเนื่องไปจนถึงปี 2027 สัญญาณที่มีประโยชน์ที่สุดไม่ได้มีแค่ชื่อโหนดใหม่ๆ เท่านั้น ต้องจับตาดูว่ากระบวนการผลิต A16 ของ TSMC และตระกูล 18A ของ Intel จะถูกนำไปใช้ในผลิตภัณฑ์ของลูกค้าในวงกว้างหรือไม่ HBM4 และ HBM4E จะพร้อมใช้งานในปริมาณมากเร็วแค่ไหน UCIe 3.0 จะสร้างความสามารถในการทำงานร่วมกันระหว่างชิปเล็ตจากหลายผู้ผลิตได้อย่างมีนัยสำคัญหรือไม่ CXL 4.0 จะปรากฏในระบบการผลิตที่ใด และออปติกแบบรวมแพ็คเกจจะคุ้มค่าและใช้งานได้จริงในระดับการใช้งานขนาดใหญ่หรือไม่
ความสำเร็จเหล่านั้นจะแสดงให้เห็นว่าอุตสาหกรรมเซมิคอนดักเตอร์จะสามารถพัฒนา AI และซูเปอร์คอมพิวเตอร์ต่อไปได้หรือไม่ โดยไม่ปล่อยให้การเคลื่อนย้ายหน่วยความจำ การจ่ายพลังงาน การเชื่อมต่อเครือข่าย และการระบายความร้อน มาบั่นทอนความก้าวหน้าที่ได้จากการเพิ่มความหนาแน่นของวงจรลอจิก
สรุปแล้ว
อนาคตของ AI และซูเปอร์คอมพิวเตอร์นั้นขับเคลื่อนด้วยวิศวกรรมเซมิคอนดักเตอร์ที่ประสานงานกันมากกว่าแค่ "โหนดถัดไป" เพียงอย่างเดียว ทรานซิสเตอร์ GAA และระบบจ่ายไฟด้านหลังช่วยปรับปรุงพื้นฐานตรรกะ ชิปเล็ตและบรรจุภัณฑ์ขั้นสูงช่วยให้นักออกแบบประกอบระบบขนาดใหญ่กว่าที่ชิปตัวเดียวจะรองรับได้อย่างสะดวกสบาย HBM4 ป้อนข้อมูลให้กับตัวเร่งความเร็วด้วยแบนด์วิดท์สูงมาก UCIe, CXL, NVLink, Infinity Fabric และเครือข่ายใยแก้วนำแสงเคลื่อนย้ายข้อมูลข้ามโดเมนที่ใหญ่ขึ้นเรื่อยๆ
หากคุณกำลังเลือกฮาร์ดแวร์ ให้เริ่มต้นด้วยจุดที่เป็นคอขวดที่แท้จริงของภาระงานของคุณ สำหรับ AI ที่ใช้หน่วยความจำจำนวนมาก ให้ให้ความสำคัญกับความจุและแบนด์วิดท์ของ HBM สำหรับการฝึกอบรมแบบกระจาย ให้ให้ความสำคัญกับโครงสร้างการขยายขนาดทั้งแบบเพิ่มขึ้นและแบบกระจาย สำหรับการคำนวณทางวิทยาศาสตร์ ให้ตรวจสอบประสิทธิภาพของ FP64 และไลบรารี สำหรับการใช้งานในระดับองค์กร ให้พิจารณาพลังงาน การระบายความร้อน การสนับสนุนซอฟต์แวร์ และความพยายามในการบูรณาการในการตัดสินใจ เซมิคอนดักเตอร์ที่เร็วที่สุดในทางทฤษฎี ไม่ได้หมายความว่าจะเป็นระบบที่เร็วที่สุดหรือประหยัดที่สุดสำหรับภาระงานของคุณเสมอไป
เอกสารอ้างอิงหลัก